
Inhalt
Lernziel Modul 1
Der Teilnehmer versteht, warum LLMs stateless sind, nicht-deterministisch antworten und in einer Agent-Schleife arbeiten — und kann daraus die typischen Einstiegsfehler ableiten.
- Stateless — das Modell behält nichts; wer den Kontext herstellt, macht die eigentliche Arbeit.
- Nicht-deterministisch — dieselbe Eingabe kann zwei Antworten erzeugen; verlässlich ist nur das Abnahmekriterium, nicht der Weg.
- Agent-Schleife — denken, Werkzeug rufen, Ergebnis lesen, weiter: daran hängt alles, was Claude Code tut.
- Einstiegsfehler — jeder typische Anfängerfehler folgt aus einem dieser drei Punkte, keiner ist Zufall.
Übung 1a — Die Grundlage anlegen
Bevor irgendetwas gebaut wird: Ihr messt, warum es CLAUDE.md gibt — mit derselben Frage, dreimal gestellt.
/initim leeren Verzeichnis. Notiert, was passiert und mit welcher Begründung.- Projekt beschreiben (Prompt 0), dann die Gegenfrage stellen — es weiß es.
/clear, dieselbe Frage: weg. Nichts davon hat überlebt.CLAUDE.mdvon Hand schreiben — drei Rubriken: Fachlich · Stack · Konventionen. Gerüst:starter/CLAUDE.md.vorlage./clear, dieselbe Frage ein drittes Mal: wieder da — ohne dass ihr etwas gesagt habt.
cd ~/kurs/ctrain-seminar-app
git init && claude
Dauer ca. 13 Minuten · Einzelarbeit
Übung 1a2 — Das Gerüst aus der Grundlage
Jetzt zahlt sich die Datei aus: Der Prompt nennt keine Eckdaten mehr — die holt sich das Werkzeug aus CLAUDE.md.
- Prompt 1 absetzen. Er sagt nicht, wie das Package heißt oder welche Java-Version gilt.
- Warten, bis
mvn testgrün ist. Fehler zurückgeben, nicht selbst reparieren. - Nachprüfen: Stimmen groupId, artifactId und Package mit eurer
CLAUDE.mdüberein? Ihr habt sie nicht genannt. - Sichern:
!git add -A && git commit -m "erstes Geruest"
Dauer ca. 9 Minuten · Einzelarbeit · hier ist Pause — Auflösung auf der nächsten Folie
Auflösung Übung 1a und 1a2
Dieselbe Frage, dreimal gestellt — drei verschiedene Antworten.
Der Unterschied liegt nicht im Modell, sondern in dem, was mitgeschickt wurde.
/inithat nichts geschrieben, weil es nichts zu beschreiben gab. Es liest die Wirklichkeit, es erfindet sie nicht.- Gesagt — weiß es. Nach
/clear— weiß es nichts: Der Kontext ist weg, eine zweite Quelle gibt es nicht. - Mit
CLAUDE.md— weiß es wieder. Die Datei wird bei jedem Start automatisch mitgeschickt. - Und das Gerüst? Package, groupId und Java-Version standen in keinem Prompt. Die Datei wird nicht nur gelesen — es wird danach gehandelt.
## Fachlich
was gebaut wird, welche Regeln gelten
## Stack
Sprache, Build, Tests — und die Lücken:
„Persistenz: noch keine"
## Konventionen
Package, KISS, DRY, Test je Fachlogik
# Gerüst: starter/CLAUDE.md.vorlage
Warum Gesagtes den Session-Wechsel nicht überlebt, kommt gleich: Kapitel 3, Understanding Stateless AI.
Das Modell sieht keine Wörter
Text wird vor der Verarbeitung in Tokens zerlegt — Bausteine zwischen Zeichen und Wort.
Deutsche Komposita zerfallen in mehr Tokens als englische Wörter — derselbe Inhalt kostet auf Deutsch spürbar mehr.
Warum euch das interessieren muss
Kosten
Abgerechnet wird pro Token — Ein- und Ausgabe getrennt.
Kontextfenster
Die Obergrenze ist in Tokens definiert, nicht in Dateien.
Geschwindigkeit
Mehr Tokens = längere Antwortzeit, linear spürbar.
Qualität
Ein volles Fenster ist nicht nur teuer — es wird auch schlechter (Modul 3).
Reasoning in einem Satz
Ein Regler zwischen Kosten und Sorgfalt, kein Ein/Aus-Schalter für Intelligenz.
Ohne Reasoning
Schnell, billig, gut bei klaren, lokalen Aufgaben: Umbenennen, Formatieren, offensichtliche Fixes.
Mit Reasoning
Langsamer, teurer, deutlich besser bei Analyse, Architektur, Fehlersuche mit mehreren Verdächtigen.
Wie das technisch funktioniert (Test-Time Compute, Chain-of-Thought, Selbstkorrektur) eigenes Deck „Exkurs: Thinking Models & Reasoning". Die Bedienung in Claude Code kommt in Modul 4.
Das Modell hat kein Gedächtnis
Ein LLM ist eine Funktion: Text rein, Text raus. Zwischen zwei Aufrufen bleibt nichts zurück.
Die Antwort: alles wird neu geschickt
| Runde | Was tatsächlich an das Modell geht |
|---|---|
| 1 | Systemprompt + Frage 1 |
| 2 | Systemprompt + Frage 1 + Antwort 1 + Frage 2 |
| 3 | Systemprompt + Frage 1 + Antwort 1 + Frage 2 + Antwort 2 + Frage 3 |
| … | … und so weiter, bis das Fenster voll ist |
Warum das bezahlbar bleibt: der unveränderte Anfang wird serverseitig wiederverwendet — Prompt Caching, siehe LLM-Grundlagen.
Was sofort daraus folgt
Gewürfelt wird bei jedem Token
Das Modell berechnet keine Antwort.
Es berechnet eine Wahrscheinlichkeitsverteilung über das nächste Token — und zieht daraus.
canceldeleteremovedropdelete … ein Wegcancel … ein andererKonsequenz für die Arbeitsweise
Funktioniert nicht
„Es hat gestern geklappt, also klappt es heute."
„Ich schreibe den perfekten Prompt und bekomme immer dasselbe."
„Der Kollege hat denselben Prompt — also dasselbe Ergebnis."
Funktioniert
Verifizierbare Ergebnisse statt reproduzierbarer Wege.
Tests, Build, Diff, laufende Anwendung — etwas, das objektiv grün oder rot ist.
Der Weg darf variieren, das Abnahmekriterium nicht.
Übung 1b — Zweimal derselbe Prompt
Ihr habt gerade gehört, warum zwei Läufe verschieden ausfallen.
Jetzt messt ihr es — am eigenen Projekt.
- Prompt 2 absetzen und den Lauf auf einem Branch festhalten.
- Zurück auf das Gerüst — beide Läufe brauchen denselben Ausgangspunkt.
/clear, denselben Prompt erneut, zweiter Branch.git diffzwischen beiden — undvergleich.mdausfüllen: Form und Fachlichkeit getrennt.
!git switch -c lauf-1 && git commit -am "lauf 1"
!git switch main
# /clear, Prompt 2 erneut, dann
!git switch -c lauf-2 && git commit -am "lauf 2"
!git diff lauf-1 lauf-2
Dauer ca. 10 Minuten · Einzelarbeit · Auflösung auf der nächsten Folie
Auflösung Übung 1b
Wahrscheinlich weniger Unterschied als erwartet — und genau das ist das Ergebnis.
- Typisch variiert: Methoden- und Testnamen, gewählte Testdaten, Reihenfolge. Die Form.
- Oft identisch: die Fachlogik selbst. Bei einer engen Aufgabe taucht die Produktivklasse im Diff manchmal gar nicht auf.
- Warum so wenig Spielraum? Ihr habt ihn selbst weggenommen: klare Aufgabe, Konventionen in
CLAUDE.md, eine bestehende Klasse als Vorbild. - Der Umkehrschluss: Varianz ist kein Naturgesetz, sondern der Rest an Freiheit, den ihr gelassen habt.
Deshalb dreht sich Modul 3 um Context Engineering und Modul 4 um Verifiable Outputs: einengen, was einzuengen ist — und den Rest am Ergebnis prüfen.
Vom Textgenerator zum Agenten
Ein Agent ist eine LLM in einer Schleife — mit einem Client (Claude Code), der die Werkzeuge ausführt und den Kontext wachsen lässt:
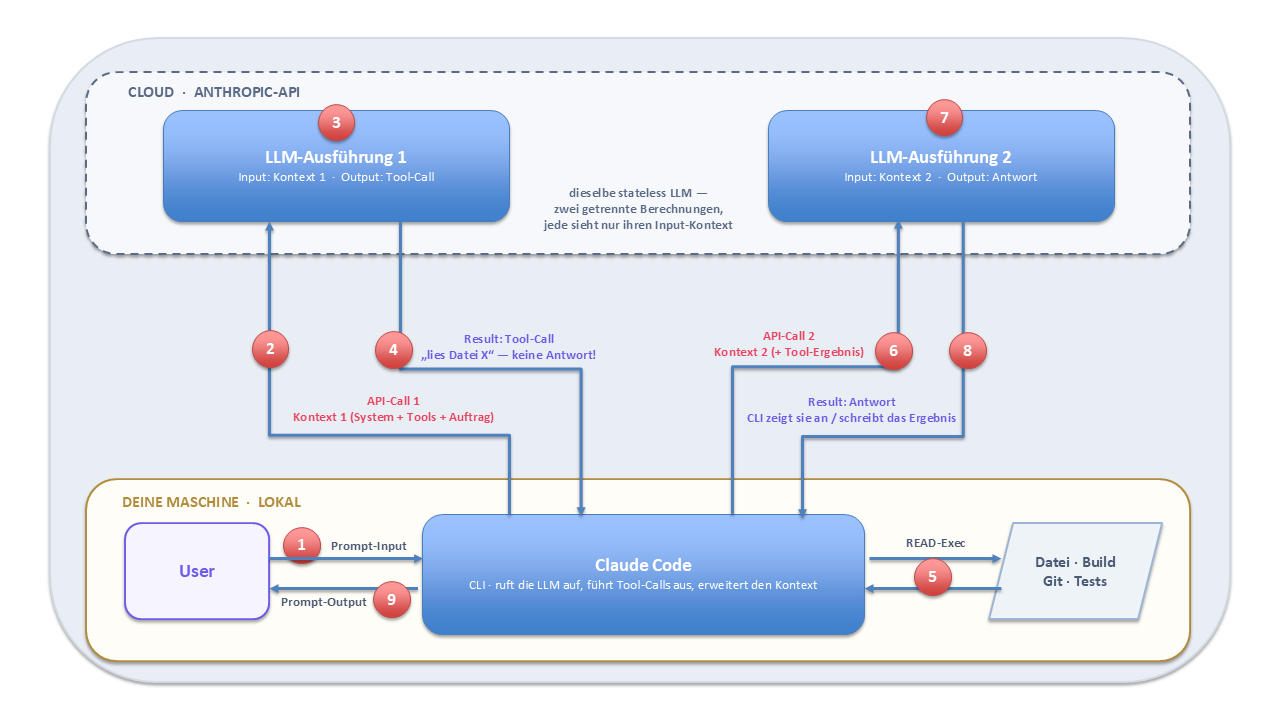
Der Bestell-Zyklus 4–6 wiederholt sich pro Werkzeug; am Ende (9) zeigt die CLI dem User das Ergebnis.
Die Schleife konkret: eine Datei lesen
development-konzept.md zusammen" — Claude Code baut Kontext 1 (System-Prompt + Tool-Defs + Frage) und ruft die LLM.Read("development-konzept.md") zurück. Call 1 endet.nächster Tool-Call
Wie ein Tool-Call wirklich aussieht
Der Tool-Call ist kein Text, den jemand herausliest — er ist ein typisierter JSON-Block, den die Schnittstelle zurückgibt.
- Kein Erkennen von Befehlen: Werkzeugname und Argumente kommen strukturiert aus der Schnittstelle, nicht aus einem Parser.
- Ausgeführt wird beim Client: das Modell führt nichts aus — Claude Code tut es.
- Kein Git-Adapter: ein Werkzeug
Bash, ein freier Befehls-String — der Interpreter ist eure Shell. - Das Ergebnis fährt im nächsten Aufruf mit — deshalb wächst der Kontext mit jedem Werkzeug.
tools: [ { name: "Bash", input_schema: { command: string } }, … ]
# 2. Antwort des Modells — stop_reason: "tool_use"
{ "type": "tool_use", "id": "toolu_01A…",
"name": "Bash", "input": { "command": "git status --short" } }
# 3. Claude Code führt aus, Ergebnis in den NÄCHSTEN Aufruf
{ "type": "tool_result", "tool_use_id": "toolu_01A…",
"content": " M src/BookingService.java" }
Was daran heikel ist, zeigt Modul 8.
Agent Mindset
Die produktivste Haltung ist weder „mächtiges Orakel" noch „dummer Autovervollständiger", sondern:
Aufgaben zuschneiden
So groß wie ein Ticket, nicht wie ein Projekt.
Kontext liefern
Was ein neuer Kollege bräuchte, braucht der Agent auch.
Ergebnisse prüfen
Vertrauen entsteht durch Nachsehen, nicht durch Hoffnung.
Eingreifen
Früh abbrechen ist billiger als spät reparieren.
Jede Mechanik hat ein Baukasten-Teil
Der Claude-Code-Baukasten aus Modul 2 ist keine Featureliste — jedes Teil beantwortet eine Mechanik von heute Vormittag:
| Mechanik (dieses Modul) | Problem im Alltag | Baukasten-Antwort (Modul 2) |
|---|---|---|
| Stateless — nichts überlebt den Aufruf | Konventionen müssten jedes Mal neu erzählt werden | CLAUDE.md & Memory — wird automatisch immer mitgeschickt |
| Tool-Defs belegen Slot 0 | Jedes Werkzeug kostet Kontext, bevor es genutzt wird | Skills & MCP bewusst auswählen statt alles laden |
| Nicht-Determinismus | Gleicher Prompt, anderes Ergebnis | Verifikation & Gates — Commands, Review-Workflows |
| Agent-Schleife mit Tool-Calls | Der Agent handelt selbstständig — wo greift man ein? | Permissions & Hooks — Eingriffspunkte vor/nach jedem Tool-Call |
| Kontext ist endlich und wächst nur | Lange Sessions degradieren | Subagents — Teilaufgaben in eigenem Kontext |
| Aufgabenhärte variiert | Spitzenmodell für Fleißarbeit ist Verschwendung | Modellwahl pro Session/Subagent |
Wo Agents wirklich stark sind
Erschließen
Unbekannte Codebasis, unbekannter Stack — Fragen beantworten mit Belegstelle.
Tests nachrüsten
Ungetesteten Code absichern, bevor man ihn anfasst.
Mechanische Änderungen
Umbenennen, Migrieren, Muster über viele Dateien ziehen.
Erste Fassungen
Gerüst, Doku, Boilerplate — alles, was man leichter korrigiert als schreibt.
Fehlersuche mit Reproduktion
Wenn ein Test rot ist, hat der Agent ein objektives Ziel.
Übersetzen
Zwischen Sprachen, Frameworks, Formaten — sofern verifizierbar.
Wo es zuverlässig scheitert
Ungeschriebenes Wissen
„Das machen wir hier immer so" steht nirgends — also weiß er es nicht.
Große Umbauten am Stück
Je größer der Schritt, desto wahrscheinlicher der Irrweg.
Unklare Ziele
Ohne Abnahmekriterium produziert er etwas Plausibles statt etwas Richtiges.
Sehr Neues
Frische Library-Versionen liegen jenseits des Trainingsstands.
Echte Abwägungen
Fachliche Priorisierung, Risikoentscheidungen, Kundenversprechen.
Was er nicht sehen kann
Laufende Prod-Umgebung, Log-Verhalten, echtes Nutzerverhalten.
Die typischen Einstiegsfehler
| Fehler | Kommt her von… | Gegenmittel |
|---|---|---|
| „Bau mir die App" — Auftrag zu groß | Agent-Bild als Orakel | Zerlegen, Modul 5 |
| Ewige Session, wird immer schlechter | Stateless nicht verstanden | Session-Hygiene, Modul 4 |
| Konventionen im Chat statt im Repo | Illusion von Gedächtnis | CLAUDE.md, Modul 7 |
| Diff ungelesen übernommen | Vertrauen statt Verifikation | Review-Loops, Modul 4/9 |
| Alles blind bestätigen | Approval Fatigue | Permissions bewusst setzen, Modul 4 |
| Kein Abnahmekriterium genannt | Nicht-Determinismus ignoriert | Verifiable Outputs, Modul 4 |
| Halluzinierte API geglaubt | Cut-off nicht bedacht | Verifizieren lassen, Modul 3 |
Kein Fehler ist Zufall.
Die Modell-Familien: Fable, Opus, Sonnet, Haiku
Fable
Die Spitze: das fähigste allgemein verfügbare Modell, gebaut für langlaufende Agenten. Für die härtesten Aufgaben.
1M-Token-Fenster · langsamstes Tempo · ca. 2× Opus-Preis · neuer Tokenizer: gleicher Text ergibt ca. 30 % mehr Tokens als bei älteren Modellen
Opus
Erste Wahl für komplexes agentisches Coding: schwierige Analyse, Architektur, verzwickte Fehlersuche.
1M-Token-Fenster · moderates Tempo · Referenzpreis
Sonnet
Der Ausgleich zwischen Stärke, Tempo und Preis — der Alltagsarbeiter.
1M-Token-Fenster · schnell · deutlich günstiger als Opus
Haiku
Klein und schnell. Für mechanische, klar umrissene Aufgaben und Hilfsläufe.
200k-Fenster · am schnellsten · am günstigsten · älterer Wissens-Cut-off
Faustregeln zur Modellwahl
Benchmarks vs. Realität
Was Benchmarks messen
Abgeschlossene, saubere Aufgaben mit eindeutiger Lösung, ohne Altlasten, ohne Firmenkonventionen, ohne 200 Dateien Kontext.
Was euer Alltag ist
Gewachsener Code, halbdokumentierte Entscheidungen, Sonderfälle vom letzten Kunden, ein Build, der nur auf einem Rechner grün ist.
Sie sagen nichts darüber, wie viel Nutzen ihr in eurem Repo habt.
Der einzige belastbare Benchmark ist ein Pilotprojekt bei euch.
Wie das Verhalten entsteht
Beides klingt gleich gut.
Cut-off Dates
Das Trainingswissen endet an einem Stichtag.
Alles danach ist dem Modell unbekannt — und es merkt das nicht.
so, wie sie damals aussahen
eure letzten sechs Monate Projektgeschichte
Gefährlich
Es sagt nicht „kenne ich nicht". Es rät eine plausible API — Methodenname, Signatur und Beispiel sehen perfekt aus und existieren nicht.
Gegenmittel
Nachschlagen lassen statt erinnern lassen: Doku holen, im Projekt suchen, kompilieren. Der Compiler ist der beste Halluzinationsdetektor.
Übung 1c — Aus dem Gerüst wird ein Dienst
Der letzte Schritt von Tag 1 am eigenen Projekt: ein größerer, riskanterer Auftrag.
Der Agent baut um, ihr prüft.
- Umbau beauftragen (Prompt rechts). Ziel vorgeben, nicht die Schritte.
CLAUDE.mdnachziehen — aus „Schnittstelle: noch keine" wird etwas anderes. Das ist der Lernpunkt.- Abnahme:
mvn quarkus:devläuft, der Endpunkt antwortet. - Sichern:
!git add -A && git commit -m "quarkus"
mvn quarkus:dev
curl localhost:8080/seminare/1/freie-plaetze
Dauer ca. 20 Minuten · Einzelarbeit · letzter Praxisteil von Tag 1
Modul 1 in vier Sätzen
Glossar Modul 1 Glossar
Grundbegriffe (LLM, Token, Kontextfenster, Stateless …) im Glossar des Vorkapitels LLM-Grundlagen.